
Viele Auswertungen lassen mehrere Sprachmodelle über dieselbe Antwort urteilen und nehmen die Mehrheit. Die Einigkeit wird dabei gern als Sicherheit gelesen. Beides setzt voraus, dass die Stimmen unabhängig sind. voteworth ist ein kleines offenes Paket, das diese Annahme prüft.
Was es misst. Für jedes Paar von Stimmen zählt voteworth, wie oft beide von der Mehrheit des Gremiums abweichen und dabei dieselbe Antwort geben. Daraus folgen drei Größen: die effektive Zahl unabhängiger Stimmen nach Kish, ein Gewicht je Stimme (1 geteilt durch 1 plus die Summe ihrer geteilten Fehler) und eine korrigierte Abstimmung. Für die Gewichtung sind keine Musterlösungen nötig, die Rechnung ist geschlossen und braucht nur numpy.
Was die mitgelieferten Daten zeigen. Zehn echte Modellstimmen aus vier Modellfamilien über achtzig Fragen, ohne Netz und ohne API-Schlüssel nachrechenbar: - Das Gremium ist 1,48 unabhängige Stimmen wert. - Lagen zwei Stimmen desselben Modells daneben, lagen sie in 42,8 Prozent der Fälle gleich daneben, bei verschiedenen Modellen in 18,5 Prozent. - Auf der zurückgehaltenen Hälfte (29 Fragen) hob die gewichtete Abstimmung die Trefferquote von 44,8 auf 51,7 Prozent und senkte die Selbstüberschätzung. Die beste Einzelstimme lag mit 58,6 Prozent weiter vorn; hier war Abstimmen der falsche Zug, und voteworth zeigt genau das.
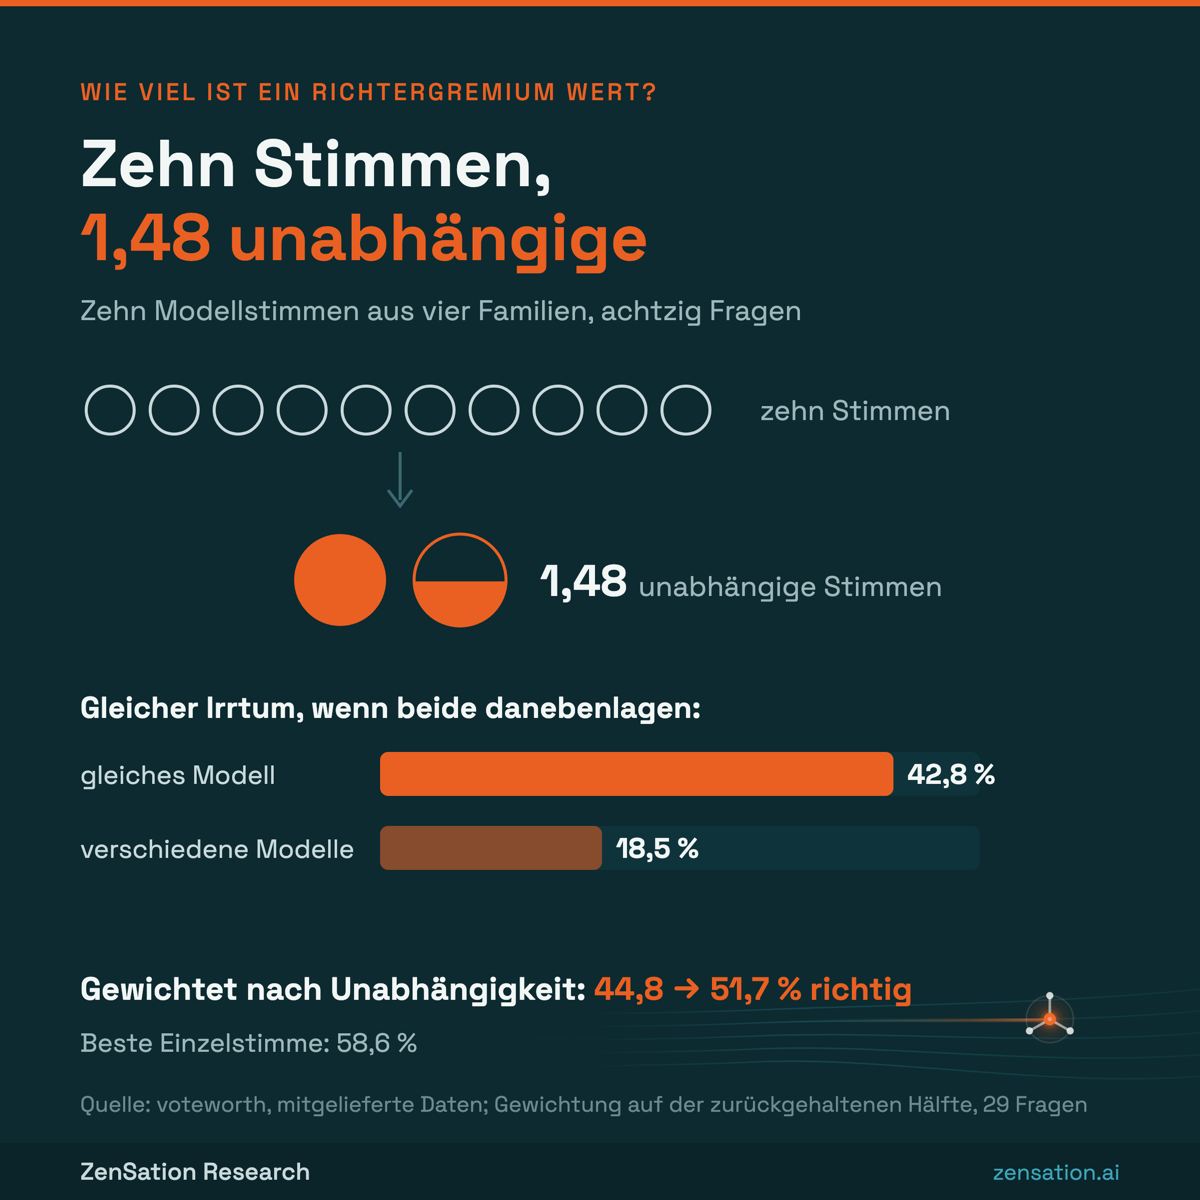
Grafik: voteworth 0.1.0, mitgelieferte Daten. Gewichtung und Trefferquote auf der zurückgehaltenen Hälfte (29 Fragen).
Die Grenze, offen benannt. Ein Gremium aus einem einzigen Modell lässt sich durch Gewichten nicht verbessern, die Demo meldet dann „INERT“. Und hält ein gleichgeschalteter Block die Mehrheit, weicht er nie ab und sieht deshalb nicht korreliert aus; die effektive Stimmenzahl fällt trotzdem, und genau daran erkennt man den Fall. Ein Test im Paket sichert diese Grenze ab.
Einordnung. Verga et al. (2024) empfehlen Gremien aus verschiedenen Modellfamilien; die Messung hier zeigt, warum Vielfalt nötig ist und dass sie allein nicht genügt. voteworth ist ein Prüfwerkzeug für das eigene Gremium, kein Benchmark und keine Rangliste von Modellen.
Ausprobieren: pip install git+https://github.com/zensation-ai/voteworth && python -m voteworth.demo. Die Zahlen oben stammen aus voteworth 0.1.0, Stand Commit 12572d5, und kommen bei jedem Lauf der Demo gleich heraus.