
Am 25. Oktober 2026 erschien Memory Tax: Dissecting the Net Value of Agent Memory (arXiv 2610.34073), eine Arbeit von Forschenden der University of Illinois Urbana-Champaign, der Tsinghua University, der Renmin University, der University of Waterloo und von Verdent.ai. Sie stellt eine Frage, die in der Debatte über Gedächtnis für KI-Agenten oft fehlt: Was bringt ein Gedächtnissystem gegenüber einer einfachen Suche im rohen Verlauf?
Was gemessen wurde. Elf Systeme aus vier Bauarten (flache Speicher, Schichten mit Lebenszyklus, Graphen, trainierte Strategien) traten gegen eine einfache Suche an, auf LongMemEval-s, PersonaMem-v2 und MINT-Eval, jeweils mit drei Sprachmodellen. Auf LongMemEval-s lag keines der elf Systeme mit einem der drei Modelle über einer Suche in zwei Runden. Die Autoren nennen den Verlust die Gedächtnissteuer: Fragen, die die Suche beantwortet, das Gedächtnis aber nicht. Ihr Gegenstück ist der Gedächtnisnutzen: Fragen, die erst das Gedächtnis löst. Ein System lohnt sich, wenn der Nutzen die Steuer übersteigt.
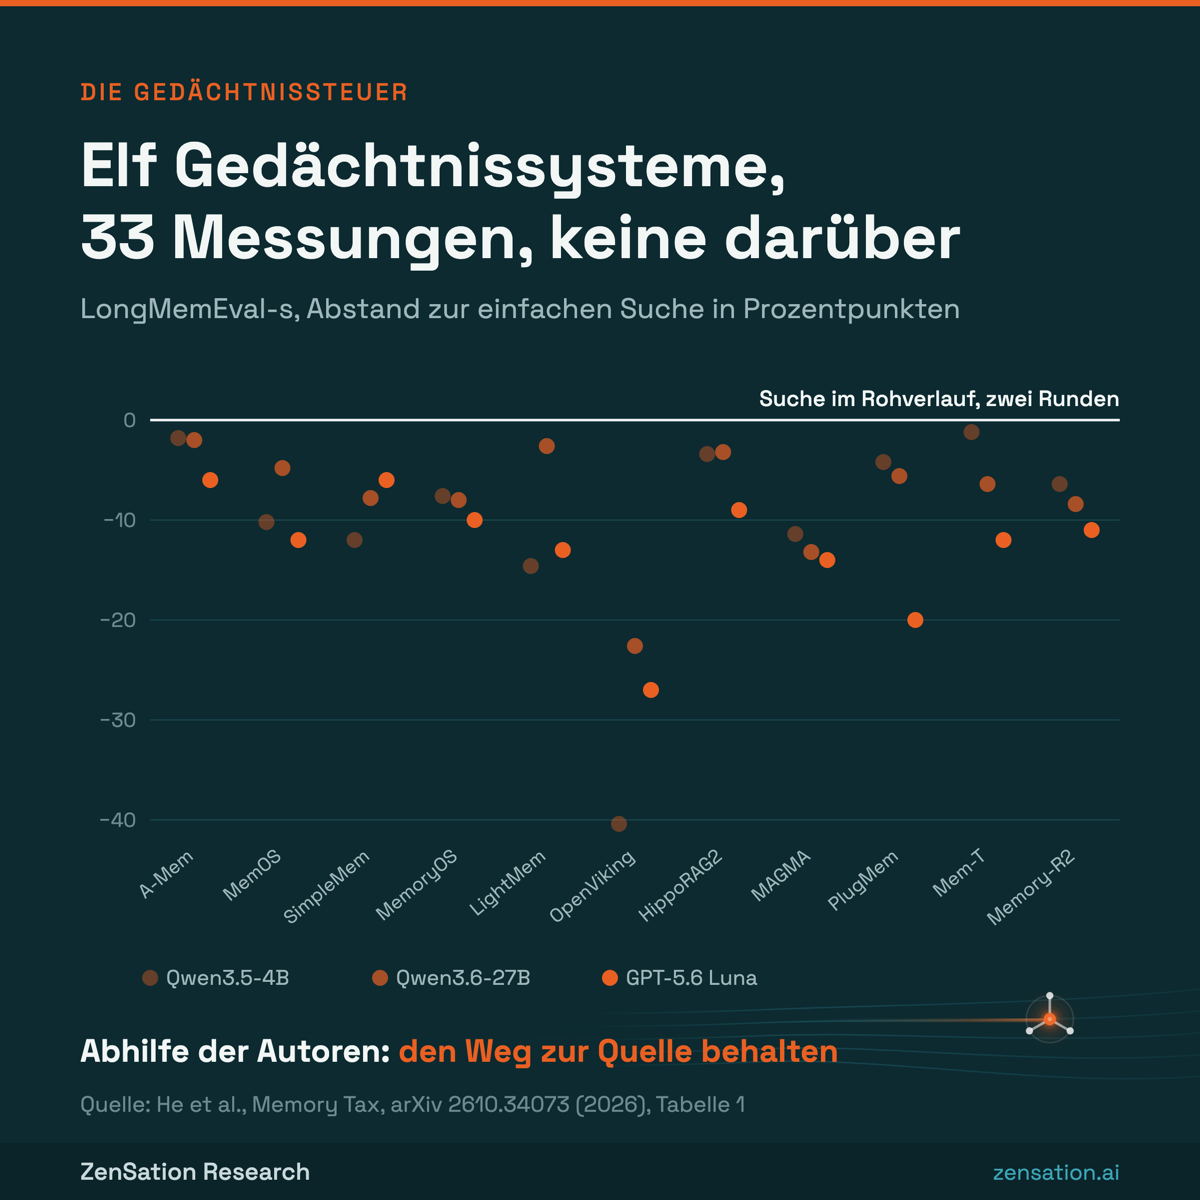
Grafik: LongMemEval-s, Tabelle 1 aus He et al. (2026). Jeder Punkt ist ein System mit einem Modell, gemessen gegen die einfache Suche in zwei Runden; mit GPT-5.6 Luna auf einer Stichprobe von 20 Prozent der Fragen.
Woher die Steuer kommt. Zwei Quellen sind gut belegt. Erstens geht beim Zusammenfassen Information verloren: In einer Stichprobe fand sich bei einem der Systeme für 38 Prozent der Fakten keine Gedächtniseinheit mehr. Zweitens wird erhaltene Information schwerer zu finden, weil sie zerlegt, mit Fremdem vermischt oder umformuliert ist. Die Autoren weisen außerdem darauf hin, dass mehrere verbreitete Benchmarks einfache Suche begünstigen, sodass ein Gedächtnis dort wenig Raum hat, seinen Nutzen zu zeigen.
Die Abhilfe. Der einfachste Vorschlag der Arbeit: einen leichten Weg zurück zur Quelle behalten, also neben dem Gedächtnis auch im Rohverlauf suchen und beide Ergebnislisten gemeinsam ordnen. In ihrem Versuch senkte das die Steuer bei mehreren Systemen.
Die Grenzen der Arbeit. Die Autoren nennen sie selbst: Die Auswahl der Systeme ist repräsentativ, nicht vollständig, und weiteres Abstimmen einzelner Systeme könnte bessere Werte bringen. Die Benchmarks sind statisch, offline und englischsprachig. Mit dem größten der drei Modelle lief LongMemEval-s aus Kostengründen auf einer Stichprobe von 20 Prozent der Fragen.
Was das Gehirn dazu sagt. Die Neurowissenschaft beschreibt dieses Prinzip seit Jahrzehnten. Nach der Theorie der komplementären Lernsysteme speichert der Hippocampus einzelne Episoden schnell, während die Großhirnrinde langsam das Allgemeine lernt (McClelland, McNaughton und O'Reilly, 1995). Nach der Transformationshypothese können die detailreiche und die verallgemeinerte Fassung einer Erinnerung nebeneinander bestehen, und welche abgerufen wird, hängt von der Aufgabe ab (Winocur und Moscovitch, 2011). Das Gehirn ersetzt die Episode also nicht durch ihre Zusammenfassung, es legt die Zusammenfassung daneben.
Wie ZenBrain das umsetzt. In ZenBrain bleibt die Episode erhalten, wenn die Konsolidierung aus ihr einen Fakt macht, und der Fakt bleibt mit seiner Episode verknüpft. Eine Suche läuft über Episoden und Fakten zugleich und ordnet alle Treffer auf einer gemeinsamen Skala von 0 bis 1. Das ist dieselbe Idee wie die Abhilfe der Arbeit, nur als Teil der Architektur statt als nachträglicher Pfad.
Quellen: He et al. (2026), arXiv:2610.34073v1 · McClelland, McNaughton, O'Reilly (1995), Psychological Review 102(3), doi:10.1037/0033-295X.102.3.419 · Winocur, Moscovitch (2011), Journal of the International Neuropsychological Society 17(5), doi:10.1017/S1355617711000683 · ZenBrain auf GitHub (Apache 2.0).